Trie 字典树
代码模板Trie 把字符串的公共前缀压到同一条树路径上,让查找和前缀统计只和字符串长度有关。
一句话算法
Trie 把字符串的公共前缀压到同一条树路径上,让查找和前缀统计只和字符串长度有关。
问题模型
维护一批小写字符串,支持:
- 插入字符串;
- 判断某个字符串是否出现过;
- 统计有多少字符串以某个前缀开头。
如果每次都逐个字符串比较,复杂度会和字符串总数有关。Trie 用树保存公共前缀,使单次操作复杂度变成
核心直觉
Trie 中,节点不是字符,边才代表字符。
从根出发,沿着字符边走:
root --a--> node --p--> node --p--> node
这条路径就表示前缀 "app"。
多个字符串如果有相同前缀,就会共享这段路径。把 "app"、"apple"、"apply"、"apt"、"bat" 插入后,Trie 如下:
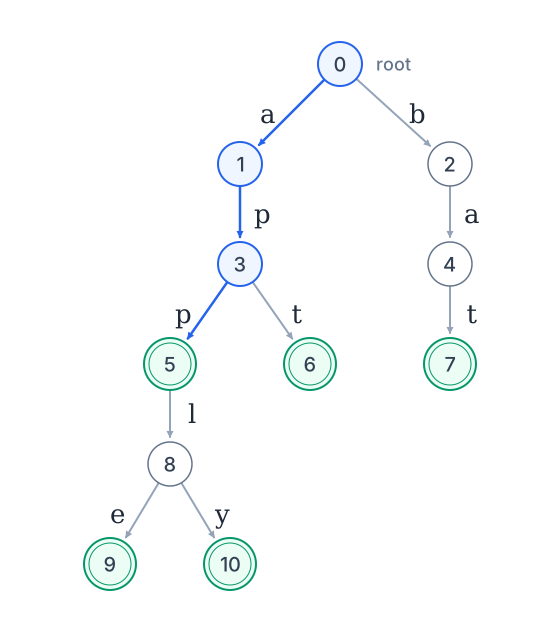
图中的圆圈只表示节点,边上的标签才表示字符。绿色双圈节点表示 end > 0:"app" 在第三个 p 后结束,但还能沿 l 继续走到 "apple" 和 "apply";"apt" 则在第二个 p 后分出另一条路径。
节点维护什么
常见 Trie 节点维护:
ch[26]:每个字符对应的孩子节点;pass:有多少字符串经过这个节点;end:有多少字符串在这个节点结束。
pass 用于前缀计数,end 用于完整字符串查询。
算法步骤
插入字符串
- 从根节点开始。
- 依次读入每个字符
c。 - 如果当前节点没有
c这条边,就创建新节点。 - 走到孩子节点,并让
pass++。 - 字符串结束时,让
end++。
查询完整字符串
- 从根节点开始沿字符走。
- 如果某条边不存在,说明字符串不存在。
- 若能走完整个字符串,检查末尾节点
end > 0。
查询前缀数量
- 先走到前缀对应节点。
- 如果走不到,答案是
0。 - 否则答案是该节点的
pass。
算法证明
核心不变量:任意节点对应从根到该节点的一段前缀,pass 等于插入过的字符串中拥有这个前缀的数量。
插入时,每经过一个节点,就说明当前字符串拥有该节点对应前缀,因此 pass++ 正确。
完整查询时,若路径不存在,则没有任何已插入字符串拥有这个字符序列;若路径存在且 end > 0,说明确实有字符串在这里结束。
前缀查询时,前缀节点的 pass 已经统计所有经过它的字符串数量,所以答案正确。
复杂度分析
设字符串长度为 26。
- 插入:
。 - 查询完整字符串:
。 - 查询前缀数量:
。 - 空间复杂度:
,数组版常数较大但速度稳定。
代码模板
竞赛中可直接复用的 Trie 结构体,支持插入、完整查询、前缀计数:
        1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54

        // 字典树 Trie 模板:插入字符串、判断是否存在、统计前缀出现次数
// 字符集固定为小写字母 'a'..'z'(共 26 个)
// 节点维护 pass(经过次数) 和 end(单词结尾次数)
// 用法:Trie tr; tr.insert("abc"); tr.contains("abc"); tr.count_prefix("ab");
struct Trie {
  struct Node {
    int ch[26];   // ch[c] 子节点编号,0 为空(根也是 0)
    int pass = 0; // 经过该节点的字符串个数
    int end = 0;  // 以该节点结尾的完整字符串个数
  };
  const char OFFSET = 'a';

  vector<Node> tree; // tree[0] 为根

  Trie() { tree.push_back(Node()); }

  // 插入 s
  void insert(const string &s) {
    int u = 0; // root
    tree[u].pass++;
    for (char cc : s) {
      int c = cc - OFFSET;
      if (tree[u].ch[c] == 0) { // 无子节点则新建
        tree[u].ch[c] = (int)tree.size();
        tree.push_back(Node());
      }
      u = tree[u].ch[c];
      tree[u].pass++;
    }
    tree[u].end++;
  }

  // 判断 s 是否完整插入过
  bool contains(const string &s) const {
    int u = 0;
    for (char cc : s) {
      int c = cc - OFFSET;
      if (tree[u].ch[c] == 0) return false;
      u = tree[u].ch[c];
    }
    return tree[u].end > 0; // 必须作为完整单词结尾
  }

  // 统计以 prefix 为前缀的字符串个数
  int count_prefix(const string &prefix) const {
    int u = 0;
    for (char cc : prefix) {
      int c = cc - OFFSET;
      if (tree[u].ch[c] == 0) return 0;
      u = tree[u].ch[c];
    }
    return tree[u].pass;
  }
};
成员 pass 更名为 pass_count(pass 是 Python 关键字),接口语义不变。
        1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58

        # 字典树 Trie:字符集固定小写字母 'a'..'z'(26 个)。
# 节点编号 0 为根,同时充当"空指针"(0 表示子节点不存在),新节点从 1 开始编号。
# 用法:tr = Trie(); tr.insert("abc"); tr.contains("abc"); tr.count_prefix("ab")
# 注意:C++ 成员 pass 是 Python 关键字,改名 pass_count,语义不变(经过次数)。

type Nodes = list["Trie.Node"]  # 节点池,下标即编号,tree[0] 为根


class Trie:
    """tree[0] 是根;insert 维护 pass_count,end 只统计"完整单词结尾"。"""

    OFFSET: int = ord("a")  # 'a' 的 ASCII 码,用于把字符映射到 0..25

    class Node:
        """ch[c] 为子节点编号(0 表示不存在)。"""

        def __init__(self) -> None:
            self.ch: list[int] = [0] * 26  # 26 个小写字母的转移
            self.pass_count: int = 0  # 经过该节点的字符串个数
            self.end: int = 0  # 以该节点结尾的完整字符串个数

    tree: Nodes

    def __init__(self) -> None:
        self.tree = [Trie.Node()]  # 建出根节点

    def insert(self, s: str) -> None:
        """插入 s;重复插入会同时增加沿途 pass_count 与末尾 end。"""
        u = 0  # 从根出发
        self.tree[u].pass_count += 1
        for cc in s:
            c = ord(cc) - self.OFFSET
            if self.tree[u].ch[c] == 0:  # 无子节点则新建
                self.tree[u].ch[c] = len(self.tree)
                self.tree.append(Trie.Node())
            u = self.tree[u].ch[c]
            self.tree[u].pass_count += 1
        self.tree[u].end += 1

    def contains(self, s: str) -> bool:
        """s 是否作为完整单词插入过(仅是前缀不算)。"""
        u = 0
        for cc in s:
            c = ord(cc) - self.OFFSET
            if self.tree[u].ch[c] == 0:
                return False
            u = self.tree[u].ch[c]
        return self.tree[u].end > 0  # 必须落在单词结尾

    def count_prefix(self, prefix: str) -> int:
        """统计以 prefix 为前缀的字符串个数(含 prefix 本身)。"""
        u = 0
        for cc in prefix:
            c = ord(cc) - self.OFFSET
            if self.tree[u].ch[c] == 0:
                return 0
            u = self.tree[u].ch[c]
        return self.tree[u].pass_count
代码实现
完整可运行程序。模板输入格式:
n q
n 个字符串
q 个询问
询问格式:
1 s:判断完整字符串s是否出现;2 s:统计前缀s出现次数。
        1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84

        #include <bits/stdc++.h>
using namespace std;

// 字典树 Trie 模板:插入字符串、判断是否存在、统计前缀出现次数
// 模板参数:ALPHA 字符集大小,OFFSET 字符起点(如 'a')
// 节点维护 pass(经过次数) 和 end(单词结尾次数)
template <int ALPHA = 26, char OFFSET = 'a'>
struct Trie {
    struct Node {
        array<int, ALPHA> ch{}; // ch[c] 子节点编号,0 为空(根也是 0)
        int pass = 0;           // 经过该节点的字符串个数
        int end = 0;            // 以该节点结尾的完整字符串个数
    };

    vector<Node> tree;          // tree[0] 为根

    Trie() { tree.push_back(Node()); }

    // 插入 s
    void insert(const string &s) {
        int u = 0;
        tree[u].pass++;
        for (char cc : s) {
            int c = cc - OFFSET;
            if (tree[u].ch[c] == 0) {       // 无子节点则新建
                tree[u].ch[c] = (int)tree.size();
                tree.push_back(Node());
            }
            u = tree[u].ch[c];
            tree[u].pass++;
        }
        tree[u].end++;
    }

    // 判断 s 是否完整插入过
    bool contains(const string &s) const {
        int u = 0;
        for (char cc : s) {
            int c = cc - OFFSET;
            if (tree[u].ch[c] == 0) return false;
            u = tree[u].ch[c];
        }
        return tree[u].end > 0;  // 必须作为完整单词结尾
    }

    // 统计以 prefix 为前缀的字符串个数
    int count_prefix(const string &prefix) const {
        int u = 0;
        for (char cc : prefix) {
            int c = cc - OFFSET;
            if (tree[u].ch[c] == 0) return 0;
            u = tree[u].ch[c];
        }
        return tree[u].pass;
    }
};

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, q;
    cin >> n >> q;

    Trie trie;
    for (int i = 0; i < n; i++) {
        string s;
        cin >> s;
        trie.insert(s);
    }

    while (q--) {
        int op;
        string s;
        cin >> op >> s;
        if (op == 1) {
            cout << (trie.contains(s) ? "Yes" : "No") << '\n';
        } else {
            cout << trie.count_prefix(s) << '\n';
        }
    }

    return 0;
}
        1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55

        # 字典树 Trie:读入 n 个字符串后处理 q 次询问。
# op=1 判断字符串是否完整插入过(输出 Yes/No);op=2 输出以该串为前缀的字符串个数。
# 字符集为小写字母 a-z(对应 C++ 的 OFFSET='a'),0 号节点为根。
import sys


def main() -> None:
    data = sys.stdin.buffer.read().split()
    pos = 0
    n = int(data[pos]); pos += 1
    q = int(data[pos]); pos += 1

    # 每个节点:ch 为 {字符: 子节点编号},pass 为经过次数,end 为单词结尾次数。
    ch: list[dict[str, int]] = [{}]
    pass_cnt: list[int] = [0]
    end_cnt: list[int] = [0]

    for _ in range(n):
        s = data[pos].decode(); pos += 1
        u = 0
        pass_cnt[u] += 1
        for c in s:
            nxt = ch[u].get(c)
            if nxt is None:
                nxt = len(ch)
                ch[u][c] = nxt
                ch.append({})
                pass_cnt.append(0)
                end_cnt.append(0)
            u = nxt
            pass_cnt[u] += 1
        end_cnt[u] += 1

    out: list[str] = []
    for _ in range(q):
        op = int(data[pos]); pos += 1
        s = data[pos].decode(); pos += 1
        u = 0
        ok = True
        for c in s:
            nxt = ch[u].get(c)
            if nxt is None:
                ok = False
                break
            u = nxt
        if op == 1:
            out.append("Yes" if ok and end_cnt[u] > 0 else "No")
        else:
            out.append(str(pass_cnt[u] if ok else 0))

    sys.stdout.write("\n".join(out) + ("\n" if out else ""))


if __name__ == "__main__":
    main()
测试用例
输入:
4 5
app
apple
apply
bat
1 app
1 ap
2 app
2 ba
1 bat
输出:
Yes
No
3
1
Yes
应用分类详解
Trie 的本质是公共前缀树。只要题目围绕字符串集合、前缀、字典序路径,就应该考虑 Trie。
一、字符串集合查询
典型模式: 插入很多字符串,多次判断某个字符串是否出现。
识别信号: 出现“字典”“单词表”“字符串集合”。
核心建模: 一条根到节点的路径表示一个字符串。
| 应用场景 | 经典题目 | 核心思路 |
|---|---|---|
| 字符串查询 | luogu-P2580 | 用 end 标记完整字符串 |
| 前缀统计 | 字典树模板题 | 用 pass 统计经过节点的字符串数 |
二、多模式串匹配的基础结构
典型模式: 有很多模式串,需要在文本中一起匹配。
识别信号: 出现“多个关键词”“敏感词匹配”“模式串集合”。
核心建模: AC 自动机就是在 Trie 上增加失配边。
三、01-Trie 维护异或最值
典型模式: 插入数字,查询和某个数异或后的最大值或最小值。
识别信号: 出现“最大异或”“路径异或”“前缀异或”。
核心建模: 把数字看成二进制字符串,优先走相反位得到最大异或。
经典例题
1. luogu-P2580
字符串集合查询题。适合练习 insert 和 contains。
2. luogu-P4551
最长异或路径。把树上路径异或转成前缀异或,再用 01-Trie 查询最大异或。
3. luogu-P3808
AC 自动机模板题。Trie 是 AC 自动机的基础结构。
相关练习题
- 「IXOI R3」我才不玩原神呢luogu / P17416普及+/提高-
- [CSP-S 2025] 谐音替换luogu / P14363省选/NOI-